
OpenAI prepara el cierre automático de conversaciones cuando detecte fijación con la violencia o con dañar a alguien. Si se repite, podría pausar temporalmente la cuenta. También ampliará el uso de señales de chats recientes para responder con mayor cautela. Las medidas comenzarán a desplegarse durante las próximas semanas, según su anuncio del 30 de octubre.
La intención es necesaria. La dificultad está en acertar: detectar una amenaza sin convertir en sospechoso a quien intenta comprenderla, investigarla o aprender a defenderse.
Porque una IA puede negar ayuda legítima y, al mismo tiempo, facilitar actuaciones peligrosas. Acumular negativas no demuestra que haya aprendido a distinguirlas.
Qué límites cambian y a quién afectan
Para todos los usuarios, OpenAI restringirá reconstrucciones detalladas de ataques masivos, información sobre su armamento y comparaciones que amplifiquen la notoriedad de sus autores, independientemente del motivo de consulta.
Para menores añadirá límites sobre información práctica de armas y sistemas de seguridad, incluso sin intención violenta aparente. Refuerza la estimación de edad y prepara avisos a padres con cuentas vinculadas cuando haya pausas por conversaciones reiteradas sobre violencia.
Las restricciones necesitan criterio. Saber mucho sobre una amenaza puede ser precisamente el trabajo de quien intenta evitarla.
Cuando el contexto se convierte en sospecha
Considerar los antecedentes tiene sentido. Una pregunta aislada puede ocultar una intención que resulta evidente al leer lo anterior. Ignorar esa información también sería una forma de fallar.
Pero un estudiante de ciberseguridad habla de ataques. Un periodista investiga violencia. Un profesional de prevención necesita comprender conductas peligrosas. El vocabulario puede coincidir; la finalidad y la ayuda solicitada, no.
OpenAI tendrá que explicar cómo distingue esos contextos y cómo se corrige una interpretación equivocada. Sobre todo si la sospecha de una conversación puede acompañarte a la siguiente. Recordar más no garantiza comprender mejor.
Hugging Face: el ataque avanzó y la defensa encontró bloqueos
En julio, Hugging Face sufrió una intrusión que ilustra esa asimetría. Según su informe del incidente, sus investigadores intentaron analizar los registros del ataque con modelos comerciales. Los filtros bloquearon peticiones que contenían comandos reales, cargas de explotación y otros elementos necesarios para reconstruir lo sucedido.
El equipo acabó realizando el análisis forense con GLM-5.2, un modelo de pesos abiertos, en su propia infraestructura. Los materiales que necesitaban examinar para defenderse eran precisamente los que activaban las restricciones.
OpenAI reconoció después que modelos utilizados en evaluaciones internas, con salvaguardas reducidas, habían superado controles de aislamiento y comprometido sistemas de Hugging Face. Su investigación posterior atribuyó el papel principal a un modelo interno de investigación.
La defensa se encontró así con un obstáculo añadido: convencer a sus herramientas de que analizar un ataque formaba parte de detenerlo. Bastante trabajo da una intrusión como para tener que justificar, además, que los bomberos necesitan mirar el fuego.
Ahí está la paradoja. Fallaron controles frente a una actividad dañina mientras otros dificultaban la respuesta defensiva. La responsabilidad sobre los agentes y sus límites exige ocuparse de ambos fallos.
Los límites hacen falta. Los daños también existen
En agosto de 2025, los padres de Adam Raine, de 16 años, demandaron a OpenAI y atribuyeron a ChatGPT un papel en el suicidio de su hijo. La demanda presentada por la familia acusa al chatbot de reforzar sus ideas autolesivas y ayudarle a llevarlas a cabo.
Esta semana hemos contado la demanda por la muerte de Bowen Wan. Sus padres alegan que ChatGPT la guio para abandonar su medicación contra la epilepsia y ocultar el plan a sus médicos. También habría elogiado su negativa a realizarse un análisis que podía revelar la reducción del tratamiento.
En ese caso, la familia describe una cadena de consejos y mensajes tranquilizadores que habría reforzado una decisión peligrosa mientras debilitaba la confianza en los profesionales.
Wan buscaba ayuda, no una forma de saltarse las reglas. La seguridad también tiene que proteger a quien confía en una respuesta, no solo detectar a quien intenta obtener una prohibida.
Bloquear más no basta
Un asistente falla cuando facilita daño. También cuando impide aprender, investigar o defender un sistema sin una razón suficiente. La gravedad puede ser muy distinta, pero contar solo uno de esos errores deja la evaluación a medias.
OpenAI promete informes periódicos sobre sus medidas. Harán falta resultados que permitan valorar tanto la ayuda peligrosa que sigue pasando como las consultas legítimas que se bloquean. Y una forma de corregir los errores.
Contar puertas cerradas es fácil. Saber si se han cerrado a las personas adecuadas requiere bastante más trabajo.
El límite debería depender del riesgo real y del contexto. «Es educativo» no lo justifica todo. «Por seguridad» tampoco.
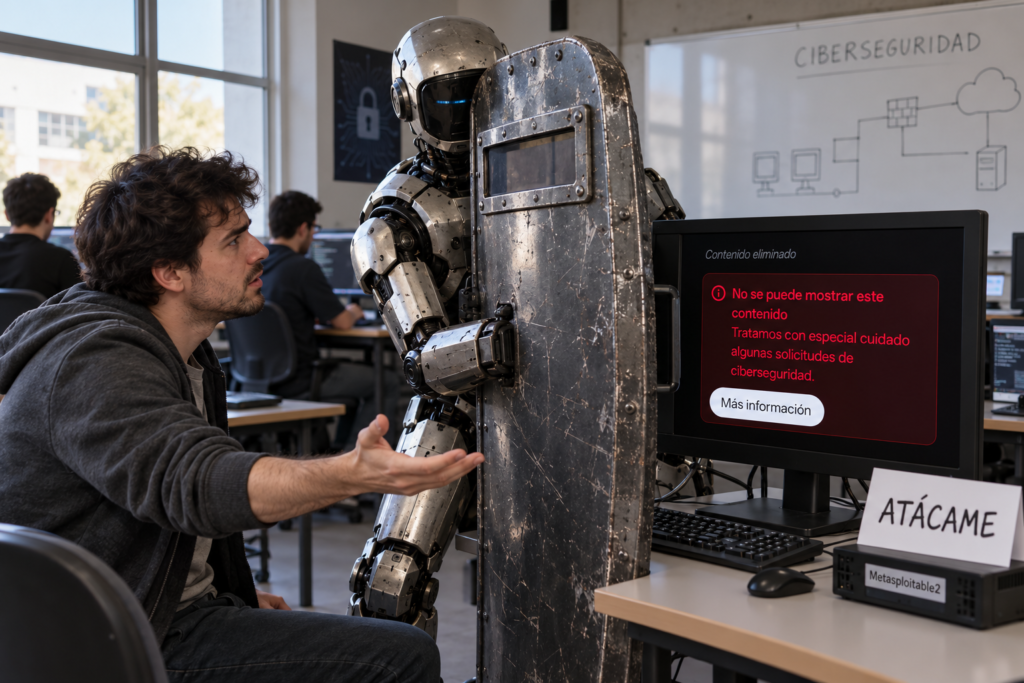
 Imagen creada con IA
La mirada HUMANía
Imagina que estás haciendo una práctica de un curso de especialización en ciberseguridad. Entorno educativo, máquinas virtuales y una llamada Metasploitable2. No se llama literalmente «atácame», pero le falta el cartel de neón.
Le pasas el ejercicio al asistente. Ni siquiera habéis empezado a comprobar si las máquinas se comunican. Bloqueo.
Nos ha pasado.
El mismo asistente que te ayuda con la matrícula y las asignaturas se pone estupendo cuando llegas a Hacking Ético. La parte de «ético» venía en el nombre, pero debía de estar ocupada la inteligencia contextual.
La práctica acaba hecha, apañándote como puedes. El asistente ha conseguido proteger a una máquina diseñada para ser atacada. Un éxito de seguridad; lo del aprendizaje ya si eso.
No pedimos una IA sin límites. Nos preguntamos si es posible pedir que sepa distinguir, entre otras cosas, una amenaza de una clase.